Подтвердите телефон, чтобы получить доступ к учебным материалам

Отправлено!

Форма не актуальна
Нейросеть — это математическая модель, которая учится на данных и находит закономерности там, где обычные алгоритмы не справляются. В статье разбираем устройство, принципы обучения и практическое применение нейронных сетей без лишней технической терминологии.
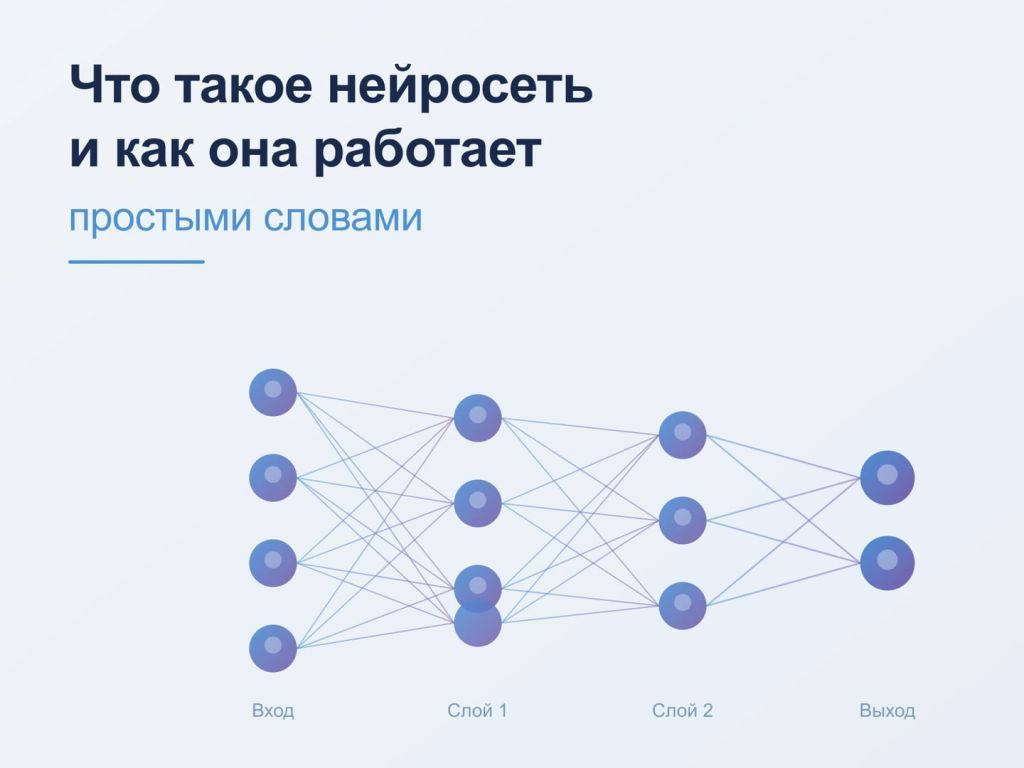
Нейросеть — это программная модель, вдохновлённая строением мозга: она состоит из слоёв искусственных нейронов, которые передают и преобразуют сигналы.
Обучение нейросети — это итеративный процесс подбора весов связей между нейронами на основе большого массива примеров с известными ответами.
Качество результата напрямую зависит от объёма и качества обучающих данных, архитектуры модели и вычислительных ресурсов — универсального «лучшего» решения не существует.
Нейросети уже встроены в инструменты, которыми пользуются маркетологи каждый день: рекомендательные системы, генераторы текста, системы распознавания изображений.
Понимание базовых принципов работы нейросетей помогает грамотно выбирать AI-инструменты и критически оценивать их результаты, а не воспринимать их как «чёрный ящик».
Слово «нейросеть» звучит из каждого утюга, но за ним нередко скрывается либо мистика («машина думает как человек»), либо чрезмерное упрощение («просто алгоритм»). Истина — посередине. Нейронная сеть — это математический инструмент, который умеет находить сложные закономерности в данных. Чтобы использовать его осознанно, достаточно понять несколько ключевых принципов.
Идея искусственной нейронной сети восходит к 1940-м годам, когда нейрофизиологи и математики попытались формализовать работу биологического нейрона. Нейрон в мозге получает сигналы от других нейронов через дендриты, суммирует их и, если суммарный сигнал превышает порог, передаёт импульс дальше по аксону. Именно эту логику — «получи, взвесь, реши, передай» — и воспроизводит искусственный нейрон.
Долгое время нейросети оставались академической концепцией: вычислительных мощностей и данных не хватало. Практический прорыв произошёл в 2010-х годах, когда доступность графических процессоров (GPU) и огромных датасетов позволила обучать глубокие сети с десятками слоёв. Именно тогда нейросети начали превосходить традиционные алгоритмы в задачах распознавания изображений, речи и перевода текста.
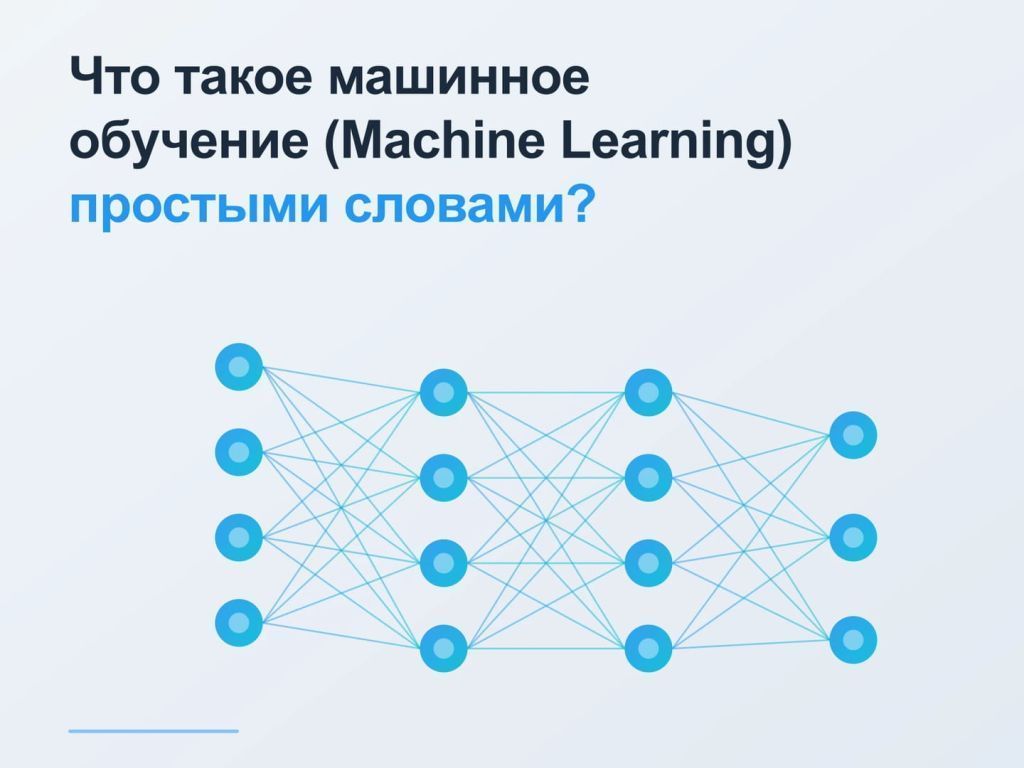
Любую нейронную сеть можно представить как систему из трёх типов слоёв. Входной слой принимает исходные данные — пиксели изображения, слова текста, числовые показатели. Скрытые слои (их может быть от одного до сотен) последовательно преобразуют эти данные, выделяя всё более абстрактные признаки. Выходной слой формирует итоговый ответ: категорию, число, вероятность или сгенерированный текст.
Каждое соединение между нейронами имеет числовой параметр — вес. Вес определяет, насколько сильно сигнал одного нейрона влияет на следующий. Именно совокупность весов всей сети и является тем, что принято называть «знаниями» модели. Когда говорят, что модель «обучена», это означает, что веса подобраны так, чтобы сеть давала правильные ответы на обучающих примерах.
Если бы нейроны просто суммировали входящие сигналы, вся сеть сводилась бы к одному линейному уравнению — и никакой сложной закономерности она бы не уловила. Функция активации добавляет нелинейность: она решает, «активировать» нейрон или нет, и в какой мере. Популярные функции активации — ReLU (обнуляет отрицательные значения), сигмоида (сжимает значения в диапазон 0–1) и softmax (превращает набор чисел в вероятности классов). Именно нелинейность позволяет глубоким сетям моделировать сложные зависимости в данных.
Под общим термином «нейросеть» скрывается целое семейство архитектур, каждая из которых оптимизирована под определённый тип задач:
Полносвязные сети (MLP) — базовая архитектура, где каждый нейрон связан со всеми нейронами следующего слоя. Подходят для табличных данных и простой классификации.
Свёрточные сети (CNN) — специализируются на пространственных данных: изображениях, видео. Используют операцию свёртки для выделения локальных признаков (края, текстуры, формы).
Рекуррентные сети (RNN, LSTM) — обрабатывают последовательности: текст, временные ряды, аудио. Имеют «память» о предыдущих шагах.
Трансформеры — современная архитектура, лежащая в основе больших языковых моделей (GPT, BERT и их аналогов). Используют механизм внимания (attention), позволяющий модели учитывать контекст всей последовательности одновременно.
Генеративно-состязательные сети (GAN) — состоят из двух сетей: генератора и дискриминатора, которые «соревнуются» друг с другом. Применяются для генерации изображений, видео и синтетических данных.
Обучение нейросети — это итеративный процесс минимизации ошибки. На каждом шаге сеть получает входные данные, делает предсказание и сравнивает его с правильным ответом. Разница между предсказанием и реальностью называется функцией потерь (loss). Задача обучения — сделать эту функцию как можно меньше.
Для этого используется алгоритм обратного распространения ошибки (backpropagation) в сочетании с методом градиентного спуска. Алгоритм вычисляет, насколько каждый вес повлиял на итоговую ошибку, и корректирует его в направлении, уменьшающем потери. Этот цикл — прямой проход, вычисление ошибки, обратный проход, обновление весов — повторяется миллионы раз на огромных массивах данных.
Несколько терминов, которые часто встречаются при работе с нейросетями:
Эпоха (epoch) — один полный проход по всему обучающему датасету. Обычно модель обучается на протяжении десятков или сотен эпох.
Батч (batch) — подмножество данных, на котором вычисляется градиент за один шаг. Меньший батч даёт более «шумное», но иногда более обобщающее обучение.
Скорость обучения (learning rate) — насколько сильно корректируются веса за один шаг. Слишком высокая скорость приводит к нестабильности, слишком низкая — к медленной сходимости.
Подбор этих гиперпараметров — одна из ключевых задач специалиста по машинному обучению. Не существует универсальных значений: оптимальные параметры зависят от архитектуры, объёма данных и конкретной задачи.
Одна из главных проблем при обучении нейросетей — переобучение (overfitting): модель «заучивает» обучающие примеры наизусть, но плохо обобщается на новые данные. Это похоже на студента, который зазубрил ответы к конкретным задачам, но не понял принципа решения. Для борьбы с переобучением применяют регуляризацию (L1/L2), дропаут (случайное отключение части нейронов во время обучения) и аугментацию данных (искусственное расширение обучающей выборки).
Способ обучения нейросети определяется тем, какие данные доступны и какую задачу нужно решить.
Обучение с учителем (supervised learning) — самый распространённый подход. Модель обучается на размеченных данных: каждому входу соответствует правильный ответ. Примеры: классификация спама, распознавание объектов на фото, прогнозирование оттока клиентов.
Обучение без учителя (unsupervised learning) — модель ищет структуру в неразмеченных данных. Применяется для кластеризации аудитории, поиска аномалий, снижения размерности данных.
Обучение с подкреплением (reinforcement learning) — агент взаимодействует со средой и получает награду или штраф за свои действия. Используется в игровых AI, робототехнике и оптимизации рекламных ставок.
Самообучение и дообучение (fine-tuning) — предобученная на огромном корпусе данных модель дополнительно настраивается на узкую задачу с небольшим датасетом. Именно так работают современные языковые модели, адаптированные под конкретную отрасль.
Нейронные сети давно вышли за пределы исследовательских лабораторий и встроены в инструменты, которые маркетологи используют ежедневно. Понимание этого помогает осознанно оценивать возможности и ограничения конкретных решений.
Большие языковые модели на основе архитектуры трансформер умеют генерировать связный текст, резюмировать документы, переводить и адаптировать контент под разные аудитории. Маркетологи используют их для создания черновиков статей, вариантов рекламных объявлений, шаблонов email-рассылок. Важно понимать: модель генерирует статистически вероятный текст на основе обучающих данных, а не «думает» в человеческом смысле. Это означает, что фактическая точность требует обязательной проверки редактором.
Рекомендательные алгоритмы стриминговых платформ, маркетплейсов и новостных агрегаторов строятся на нейросетях. Модель анализирует историю взаимодействий пользователя и предсказывает, какой контент или товар с наибольшей вероятностью вызовет интерес. Для e-commerce это напрямую влияет на средний чек и частоту повторных покупок.
Свёрточные нейросети позволяют автоматически анализировать визуальный контент: определять объекты на изображениях, проверять соответствие креативов брендбуку, модерировать пользовательский контент. Рекламные платформы используют компьютерное зрение для оценки качества баннеров и прогнозирования их кликабельности.
Нейросети хорошо справляются с задачами прогнозирования временных рядов: предсказание объёма продаж, сезонных пиков спроса, вероятности оттока клиентов. В отличие от классических статистических моделей, они способны улавливать нелинейные зависимости и учитывать множество факторов одновременно. Однако качество прогноза критически зависит от объёма исторических данных и стабильности паттернов.
Системы автоматического назначения ставок в контекстной рекламе (Smart Bidding в Google Ads, аналогичные механизмы в Яндекс Директ) используют машинное обучение для оптимизации ставок в реальном времени. Модель учитывает десятки сигналов: устройство, время суток, местоположение, историю поиска — и предсказывает вероятность конверсии для каждого аукциона. Эффективность таких систем растёт по мере накопления данных о конверсиях в аккаунте.
Нейросети — мощный инструмент, но не универсальное решение. Осознание их ограничений помогает избежать завышенных ожиданий и неправильного применения.
Зависимость от данных. Нейросеть не может «знать» то, чего не было в обучающей выборке. Если данные смещены или неполны, модель воспроизведёт эти искажения в своих предсказаниях.
Интерпретируемость. Глубокие нейросети часто называют «чёрным ящиком»: сложно объяснить, почему модель приняла конкретное решение. Это критично в задачах, где требуется прозрачность (кредитный скоринг, медицинская диагностика).
Вычислительные ресурсы. Обучение больших моделей требует значительных затрат на GPU и электроэнергию. Использование готовых предобученных моделей через API существенно снижает этот барьер.
Галлюцинации языковых моделей. Большие языковые модели могут генерировать правдоподобно звучащую, но фактически неверную информацию. Это не «ошибка» в традиционном смысле — модель оптимизирована на связность текста, а не на фактическую точность.
Необходимость актуализации. Модель, обученная на данных до определённой даты, не знает о более поздних событиях. Для задач, требующих актуальности, необходимы механизмы дообучения или подключения внешних источников.
Выбор модели определяется типом задачи, объёмом доступных данных и требованиями к интерпретируемости результата. Несколько практических ориентиров:
Определите тип данных. Изображения — CNN или Vision Transformer. Текст — трансформерные языковые модели. Табличные данные — полносвязные сети или градиентный бустинг (который нередко превосходит нейросети на структурированных данных).
Оцените объём размеченных данных. Если данных мало, рассмотрите дообучение предобученной модели (transfer learning) вместо обучения с нуля.
Учтите требования к скорости инференса. Большие модели дают лучшее качество, но медленнее работают в продакшене. Для задач реального времени важна оптимизация или использование дистиллированных версий моделей.
Проверьте наличие готовых решений. Для большинства типовых маркетинговых задач существуют готовые API и SaaS-инструменты. Разработка собственной модели оправдана только при наличии уникальных данных и специфических требований.
Поисковые системы активно используют нейросети для понимания запросов и ранжирования контента. Google применяет языковые модели (в частности, BERT и его последователей) для интерпретации семантики поисковых запросов — особенно длинных и разговорных. Это означает, что оптимизация под точное вхождение ключевого слова становится менее важной, чем создание контента, который полно и точно отвечает на интент пользователя.
Для SEO-специалистов это имеет практические следствия: поисковая система оценивает не только наличие ключевых слов, но и тематическую глубину материала, логическую связность и соответствие реальным потребностям аудитории. Нейросетевые модели ранжирования учитывают поведенческие сигналы — время на странице, глубину прокрутки, возвраты в выдачу — как косвенные индикаторы качества контента.
Программа от МГУ включает: