1. Главная
  2. Блог
  3. Что такое машинное обучение (Machine Learning) простыми словами?

Что такое машинное обучение (Machine Learning) простыми словами?

Курс: AI Digital-маркетинг для менеджеров и предпринимателей
1 модуль
Управление цифровой воронкой
  • Введение в интернет-маркетинг
  • SCRUM в методологии AGILE
  • Ключевые метрики CR, CPM, CPC, CPA, CPL, CPO
  • Технологии для создания ИИ-агентов
  • Установка и настройка облачной CRM
2 модуль
SEM — поисковый маркетинг и аналитика
  • SEO — поисковая оптимизация сайта
  • Создание и использование ИИ-агентов для SEO
  • Оценка полученных результатов за предыдущий спринт
  • Установка аналитики и целей в аналитике
3 модуль
SEM — поисковый маркетинг и аналитика. Часть 2
  • Контекстная реклама
  • Настройка ремаркетинга
  • Использование ИИ-агентов для контекстной рекламы
  • Сквозная аналитика
  • Самостоятельная работа в проектных командах
4 модуль
Таргетированная реклама и работа с существующей аудиторией
  • Оценка полученных результатов за предыдущий спринт
  • SMM — маркетинг в социальных сетях
  • Таргетированная реклама
  • Разметка и анализ трафика
  • Использование ИИ-агентов для креативов
Оценка
Предварительная оценка результатов предпринимательского digital-проекта и работа над ошибками
  • Анализ полученных данных
  • Разбор ошибок команд
Защита
Защита итогового проекта
  • Презентация бизнес проекта
  • Аттестация
  • Получение удостоверения
Получить бесплатный урок

Машинное обучение — это способность компьютерных систем улучшать свою работу на основе данных без явного программирования каждого шага. Статья объясняет, как работает ML, какие виды существуют и почему эта технология стала основой современного цифрового маркетинга и бизнес-аналитики.
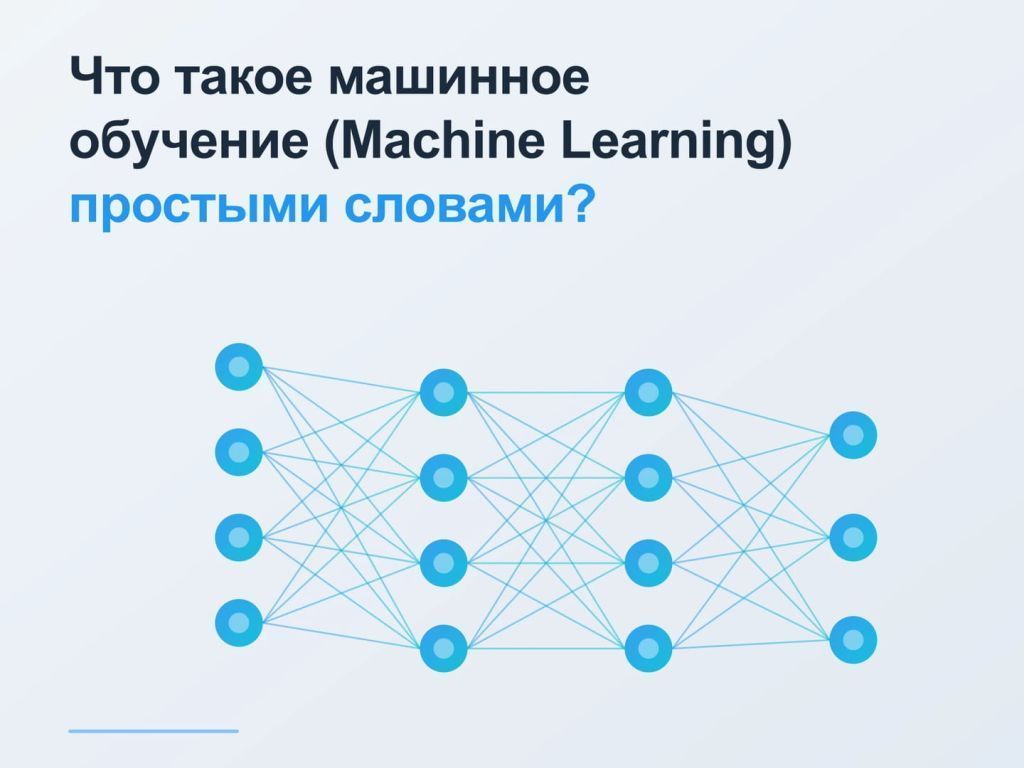
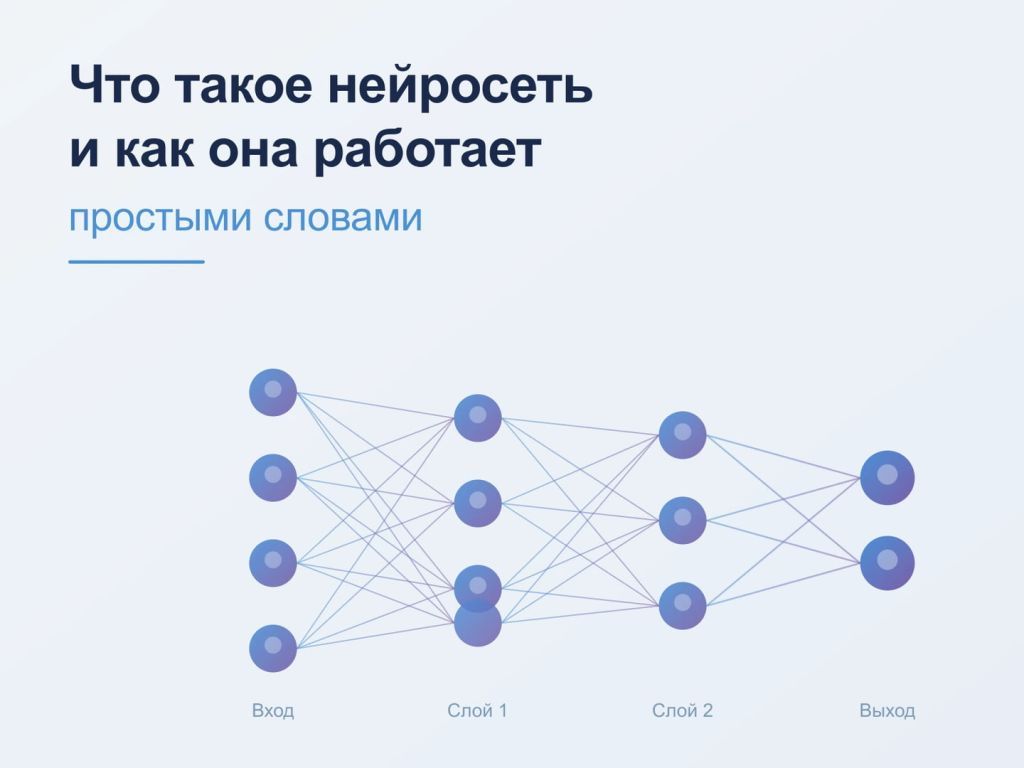
Схема машинного обучения: данные поступают в нейронную сеть и преобразуются в предсказания и инсайты

Кратко о главном

  • Машинное обучение — это раздел искусственного интеллекта, в котором модели самостоятельно находят закономерности в данных и улучшают свои предсказания без ручного программирования каждого правила.
  • Существует три основных подхода: обучение с учителем, без учителя и обучение с подкреплением — выбор зависит от типа задачи и наличия размеченных данных.
  • ML активно применяется в поисковых алгоритмах, рекомендательных системах, таргетированной рекламе и веб-аналитике, поэтому понимание его основ полезно не только разработчикам, но и маркетологам.
  • Качество результатов напрямую зависит от качества и объёма обучающих данных — «мусор на входе» даёт «мусор на выходе».
  • Внедрение ML требует чёткой постановки задачи: технология не решает бизнес-проблемы автоматически, а лишь усиливает правильно выстроенные процессы.

Простое определение: что такое машинное обучение

Машинное обучение (Machine Learning, ML) — это подраздел искусственного интеллекта, который позволяет компьютерным системам обучаться на примерах и данных, а не следовать жёстко заданным инструкциям. Вместо того чтобы программист прописывал каждое правило («если X, то Y»), алгоритм самостоятельно выявляет закономерности в большом массиве информации и использует их для принятия решений или прогнозов.

Классический пример: спам-фильтр в почте. Разработчик не перечисляет все возможные признаки спама вручную. Вместо этого алгоритм анализирует тысячи писем, помеченных пользователями как «спам» или «не спам», и сам учится отличать нежелательную почту от полезной. Чем больше данных — тем точнее модель.

Важно понимать разницу между машинным обучением и традиционным программированием. В классическом подходе: данные + правила = результат. В машинном обучении: данные + результат = правила. Алгоритм сам «выводит» правила, наблюдая за примерами.

Как работает машинное обучение: механика процесса

Процесс обучения модели можно разбить на несколько последовательных этапов. Понимание этой механики помогает оценить, где ML действительно полезен, а где его применение избыточно.

  1. Сбор и подготовка данных. Алгоритм обучается на исторических данных. Это могут быть клики пользователей, транзакции, тексты, изображения или поведенческие сигналы. Данные необходимо очистить от ошибок, дубликатов и выбросов — именно этот этап занимает большую часть времени в реальных проектах.

  2. Выбор модели. Специалист выбирает тип алгоритма в зависимости от задачи: линейная регрессия для прогнозирования числовых значений, деревья решений для классификации, нейронные сети для работы с изображениями и текстом.

  3. Обучение. Модель «прогоняет» обучающую выборку, сравнивает свои предсказания с реальными ответами и корректирует внутренние параметры, минимизируя ошибку. Этот процесс повторяется многократно.

  4. Валидация и тестирование. Обученную модель проверяют на данных, которые она не видела в процессе обучения. Это позволяет оценить, насколько хорошо модель обобщает знания, а не просто «запоминает» примеры.

  5. Развёртывание и мониторинг. Готовая модель интегрируется в продукт или бизнес-процесс. После запуска её точность регулярно отслеживается, поскольку реальные данные со временем меняются.

Ключевое ограничение: модель не «понимает» задачу в человеческом смысле. Она оптимизирует математическую функцию ошибки. Если задача поставлена некорректно или данные нерепрезентативны, модель выдаст уверенные, но бесполезные или даже вредные результаты.

Три основных вида машинного обучения

Подходы к обучению различаются в зависимости от того, какие данные доступны и какую задачу нужно решить. Каждый из трёх видов имеет свою область применения и ограничения.

Обучение с учителем (Supervised Learning)

Самый распространённый вид. Алгоритм обучается на размеченных данных — то есть на примерах, где каждому входному значению соответствует правильный ответ. Модель учится предсказывать ответ для новых, ранее не виденных данных.

  • Задачи классификации: определить, является ли письмо спамом, относится ли клиент к группе риска оттока, позитивный или негативный отзыв.
  • Задачи регрессии: предсказать стоимость клика в рекламной кампании, прогнозировать выручку на следующий квартал, оценить вероятность конверсии.

Главное ограничение — необходимость в размеченных данных. Разметка требует времени и экспертизы, а в некоторых нишах получить достаточный объём меток крайне сложно.

Обучение без учителя (Unsupervised Learning)

Алгоритм работает с неразмеченными данными и самостоятельно ищет в них скрытую структуру. Правильных ответов нет — модель выявляет группы, паттерны и аномалии.

  • Кластеризация: сегментация аудитории по поведенческим признакам без заранее заданных категорий.
  • Снижение размерности: упрощение сложных данных для визуализации или ускорения других алгоритмов.
  • Обнаружение аномалий: выявление подозрительных транзакций или нетипичного поведения пользователей.

Интерпретировать результаты обучения без учителя сложнее: алгоритм находит группы, но не объясняет, почему именно такое разбиение имеет смысл. Это требует участия эксперта в предметной области.

Обучение с подкреплением (Reinforcement Learning)

Агент обучается, взаимодействуя со средой: совершает действия, получает вознаграждение или штраф и постепенно вырабатывает стратегию, максимизирующую суммарное вознаграждение. Этот подход лежит в основе систем управления ставками в программатик-рекламе и алгоритмов рекомендаций.

Обучение с подкреплением требует большого числа итераций и чётко определённой функции вознаграждения. Если вознаграждение задано неправильно, агент найдёт способ «обмануть» систему, формально максимизируя метрику, но не достигая реальной цели.

Машинное обучение в цифровом маркетинге и SEO

Для маркетологов машинное обучение — не абстрактная технология, а инструмент, который уже встроен в большинство платформ, с которыми они работают ежедневно. Понимание того, как ML влияет на алгоритмы, помогает принимать более обоснованные решения.

Поисковые алгоритмы

Современные поисковые системы используют ML-модели для оценки релевантности страниц. Алгоритмы анализируют сотни сигналов — поведенческие факторы, качество контента, ссылочный профиль, скорость загрузки — и обучаются на том, какие результаты пользователи считают полезными. Это означает, что оптимизация под конкретные ключевые слова становится менее эффективной, чем создание контента, реально отвечающего на запрос пользователя.

Таргетированная и контекстная реклама

Рекламные платформы применяют ML для автоматического управления ставками, подбора аудиторий и оптимизации показов. Алгоритм предсказывает вероятность конверсии для каждого пользователя и корректирует ставку в режиме реального времени. Маркетолог задаёт цель (например, целевую стоимость конверсии), а система самостоятельно ищет оптимальную стратегию показов.

  • Автоматические стратегии назначения ставок работают лучше при наличии достаточного объёма данных о конверсиях — как правило, не менее 30–50 конверсий в месяц на кампанию.
  • При недостатке данных алгоритм обучается медленно, и ручное управление ставками может давать более предсказуемый результат.
  • Качество сигналов о конверсиях критично: если отслеживание настроено некорректно, алгоритм оптимизируется под неправильную цель.

Рекомендательные системы и персонализация

Алгоритмы рекомендаций на маркетплейсах, стриминговых сервисах и новостных агрегаторах используют ML для предсказания того, какой контент или товар заинтересует конкретного пользователя. Для e-commerce это напрямую влияет на средний чек и повторные покупки. Персонализированные рекомендации, как правило, показывают более высокий CTR по сравнению со статическими подборками, хотя конкретный эффект зависит от ниши и качества данных.

Веб-аналитика и прогнозирование

Инструменты аналитики всё активнее используют ML для автоматического обнаружения аномалий в трафике, прогнозирования оттока пользователей и сегментации аудитории. Это позволяет маркетологу сосредоточиться на интерпретации инсайтов, а не на ручной обработке данных. Важно понимать, что автоматические инсайты — это гипотезы, требующие проверки, а не готовые решения.

Ключевые понятия, которые стоит знать

Разбираясь в машинном обучении, полезно понимать несколько базовых терминов, которые часто встречаются в профессиональных обсуждениях.

  • Модель — математическая функция, которая принимает входные данные и возвращает предсказание или решение.
  • Признаки (features) — характеристики объектов, на основе которых модель делает предсказание (например, возраст пользователя, устройство, время суток).
  • Переобучение (overfitting) — ситуация, когда модель слишком хорошо «запомнила» обучающие данные и плохо работает на новых примерах.
  • Недообучение (underfitting) — модель слишком проста и не улавливает реальные закономерности в данных.
  • Нейронная сеть — класс моделей, вдохновлённых структурой мозга; особенно эффективны для работы с изображениями, текстом и речью.
  • Глубокое обучение (Deep Learning) — подраздел ML, использующий многослойные нейронные сети; лежит в основе современных языковых моделей и систем компьютерного зрения.

Где машинное обучение применяется на практике

ML давно вышел за рамки академических лабораторий и используется в самых разных отраслях. Ниже — наиболее показательные примеры, актуальные для бизнеса и маркетинга.

  • Электронная коммерция: динамическое ценообразование, персонализированные рекомендации товаров, прогнозирование спроса для управления складом.
  • Финансы: скоринг кредитных заявок, обнаружение мошеннических транзакций в режиме реального времени.
  • Контент-маркетинг: автоматическая генерация черновиков текстов, анализ тональности отзывов, кластеризация семантического ядра.
  • Email-маркетинг: предсказание оптимального времени отправки для каждого подписчика, сегментация по вероятности открытия письма.
  • Клиентский сервис: чат-боты на основе языковых моделей, автоматическая маршрутизация обращений по теме и приоритету.
  • Медиа и реклама: программатик-закупки, оптимизация креативов, предсказание показателя качества объявления.

Ограничения и риски машинного обучения

Машинное обучение — мощный инструмент, но не универсальное решение. Понимание его ограничений помогает избежать завышенных ожиданий и неправильного применения.

  • Зависимость от данных. Модель не может быть лучше данных, на которых обучена. Если исторические данные содержат систематические ошибки или отражают устаревшие паттерны, модель воспроизведёт эти проблемы.
  • Проблема «чёрного ящика». Сложные модели, особенно глубокие нейронные сети, сложно интерпретировать. Это создаёт трудности в регулируемых отраслях, где требуется объяснить логику принятого решения.
  • Смещение (bias). Если обучающая выборка нерепрезентативна, модель может систематически ошибаться в отношении определённых групп пользователей или сценариев.
  • Дрейф данных. Реальный мир меняется: поведение пользователей, рыночные условия, сезонность. Модель, обученная на данных прошлого года, может давать менее точные результаты сегодня без регулярного переобучения.
  • Высокий порог входа. Качественное внедрение ML требует экспертизы в области данных, инфраструктуры и предметной области одновременно. Готовые API и AutoML-инструменты снижают этот порог, но не устраняют необходимость в понимании задачи.

Машинное обучение vs искусственный интеллект: в чём разница

Эти термины часто используются как синонимы, хотя между ними есть чёткое иерархическое соотношение. Искусственный интеллект (ИИ) — широкое понятие, обозначающее любые системы, имитирующие когнитивные функции человека: рассуждение, планирование, восприятие, обучение. Машинное обучение — один из подходов к созданию ИИ, основанный на обучении по данным.

Глубокое обучение, в свою очередь, является подмножеством машинного обучения и специализируется на многослойных нейронных сетях. Именно глубокое обучение обеспечивает работу современных языковых моделей, систем распознавания речи и изображений. Таким образом, иерархия выглядит так: ИИ → машинное обучение → глубокое обучение.

С чего начать: практические шаги для маркетолога

Маркетологу не обязательно становиться специалистом по данным, чтобы эффективно работать с ML-инструментами. Достаточно понимать базовые принципы и уметь правильно ставить задачи.

  1. Определите бизнес-задачу. Сформулируйте, что именно нужно предсказать или оптимизировать: вероятность оттока клиента, оптимальное время отправки письма, наиболее конверсионный сегмент аудитории.

  2. Оцените наличие данных. Проверьте, есть ли достаточный объём исторических данных с нужными признаками. Для большинства задач классификации минимальный порог — несколько тысяч размеченных примеров.

  3. Начните с готовых инструментов. Многие платформы (рекламные кабинеты, CRM, аналитические системы) уже содержат встроенные ML-функции. Освойте их возможности, прежде чем строить собственные модели.

  4. Настройте корректное отслеживание конверсий. Качество сигналов о результатах — основа для обучения алгоритмов. Без правильно настроенной аналитики автоматические стратегии не смогут оптимизироваться под реальные цели.

  5. Тестируйте и измеряйте. Внедряйте ML-решения постепенно, сравнивая результаты с контрольной группой. Не принимайте улучшение метрики за доказательство успеха без статистически значимого теста.

Машинное обучение меняет то, как работают поисковые алгоритмы, рекламные платформы и аналитические инструменты. Маркетолог, понимающий базовые принципы ML, способен лучше интерпретировать поведение алгоритмов, точнее ставить задачи техническим специалистам и принимать более обоснованные решения об автоматизации процессов.

Следующий практический шаг — аудит тех инструментов, которые вы уже используете, с точки зрения того, какие ML-функции в них уже включены и насколько корректно они настроены под ваши бизнес-цели.

Часто задаваемые вопросы

Чем машинное обучение отличается от обычного программирования?

В традиционном программировании разработчик явно прописывает правила, по которым программа принимает решения. В машинном обучении правила не задаются вручную — алгоритм самостоятельно выводит их из данных. Это позволяет решать задачи, где правила слишком сложны или многочисленны, чтобы описать их вручную, например распознавание лиц или фильтрация спама.

Нужно ли знать математику и программирование, чтобы использовать ML?

Для глубокого понимания и разработки собственных моделей — да, математическая база и навыки программирования необходимы. Однако маркетологи и аналитики могут эффективно работать с готовыми ML-инструментами в рекламных платформах, CRM и аналитических системах без написания кода, если понимают логику работы алгоритмов и умеют правильно интерпретировать результаты.

Почему алгоритмы машинного обучения иногда ошибаются?

Ошибки возникают по нескольким причинам: низкое качество или недостаточный объём обучающих данных, нерепрезентативная выборка, некорректная постановка задачи или изменение реальных условий после обучения модели. Алгоритм оптимизирует математическую функцию, а не реальную бизнес-цель, поэтому несоответствие между ними — частый источник проблем.

Как машинное обучение влияет на SEO?

Поисковые системы используют ML-модели для оценки качества и релевантности контента, анализа поведенческих сигналов и борьбы со спамом. Это означает, что алгоритмы становятся лучше в распознавании контента, созданного исключительно для манипуляции ранжированием. Устойчивое SEO сегодня строится на реальной экспертизе и пользе для читателя, а не на технических уловках.

Что такое переобучение модели и почему это проблема?

Переобучение происходит, когда модель слишком точно подстраивается под обучающую выборку и теряет способность обобщать знания на новые данные. На практике это выглядит так: на тестовых данных модель показывает отличные результаты, а в реальных условиях — значительно хуже. Для борьбы с переобучением используют регуляризацию, увеличение объёма данных и валидацию на отдельной выборке.

Вам может быть интересно

Обучение интернет-маркетингу за 1,5 месяца

Не упустите шанс освоить востребованные навыки: привлекать клиентов, настраивать рекламу, анализировать данные и управлять цифровыми воронками продаж. Обучение проходит полностью онлайн и сочетает практику, реальные кейсы и поддержку экспертов.
Стоимость курса
135 000 рублей
Старт ближайшей группы — 27 сентября 2026 года

Программа от МГУ включает:
  • полностью онлайн-формат с доступом из любой точки мира
  • практику на реальных кейсах крупных компаний
  • обучение у ведущих экспертов из Google, Яндекса, CoMagic, «Взлёт Медиа» и других компаний
  • удостоверение о повышении квалификации МГУ, подтверждающее вашу экспертизу
Оставьте заявку и получите доступ к программе уже сегодня.
Получить доступ к вводному занятию
x

ПОЛИТИКА КОНФИДЕНЦИАЛЬНОСТИ

Данное соглашение об обработке персональных данных разработано в соответствии с законодательством Российской Федерации.

Присоединяясь к настоящему Соглашению и оставляя свои данные на Сайте https://www.digital.econ.msu.ru/ (далее – Сайт), путем заполнения полей онлайн-заявки (регистрации) Пользователь выражает Согласие на согласие на обработку персональных данных и их передачу оператору обработки персональных данных – Экономическому факультету Московского государственного университета имени М.В. Ломоносова (Адрес местонахождения: Российская Федерация, 119991, г.Москва, Ленинские горы, дом 1, строение 46) (далее – Оператор), которому принадлежит Сайт, на следующих условиях.
Пользователь:
Данное Согласие дается на обработку персональных данных как без использования средств автоматизации, так и с их использованием.

Согласие дается на обработку следующих персональных данных Пользователя, указанных Пользователем в формах или в файлах, прикрепленных к формам:

Целью обработки персональных данных является их хранение и использование, в том числе: Пользователь, принимая условия настоящего Соглашения, выражает свою заинтересованность и дает полное согласие, что обработка его персональных данных включает в себя следующие действия: сбор, запись, систематизацию, накопление, хранение, уточнение (обновление, изменение), извлечение, использование, передачу (предоставление доступа), обезличивание, блокирование, удаление, уничтожение персональных данных.

Согласие Пользователя на обработку персональных данных является конкретным, информированным и сознательным.

Настоящее Согласие Пользователя признается исполненным в простой письменной форме.

Согласие действует бессрочно с момента предоставления данных и может быть отозвано Пользователем путем подачи письменного заявления Оператору с указанием данных, определенных статьей 14 Федерального закона №152-ФЗ «О персональных данных» по адресу: Российская Федерация, 119991, г.Москва, Ленинские горы, дом 1, строение 46 на имя декана Экономического факультета МГУ имени М.В. Ломоносова.

В случае отзыва Пользователем согласия на обработку персональных данных Оператор вправе продолжить обработку персональных данных без согласия Пользователя при наличии оснований, указанных в пунктах 2-11 части 1 статьи 6, части 2 статьи 10 и части 2 статьи 11 Федерального закона №152-ФЗ «О персональных данных».

В ходе обработки персональных данных Оператор вправе осуществлять: сбор, запись, систематизацию, накопление, хранение, уточнение (обновление, изменение), извлечение, использование, передачу (распространение, предоставление, доступ), обезличивание, блокирование, удаление, уничтожение персональных данных Пользователя.

Передача персональных данных Пользователя третьим лицам не осуществляется, за исключением лиц, осуществляющих обработку персональных данных по поручению Оператора и от его имени, а также случаев, установленных законодательством. В случае участия Пользователей в мероприятиях, организуемых Оператором, последний вправе раскрыть соответствующие персональные данные Пользователей лицам, участвующим в организации такого мероприятия.

Оператор имеет право вносить изменения в настоящее Соглашение в любое время. При внесении изменений в актуальной редакции указывается дата последнего обновления. Новая редакция Соглашения вступает в силу с момента ее размещения, если иное не предусмотрено новой редакцией Соглашения.